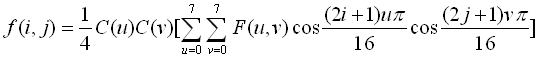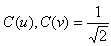AviUtl中的YUY2补间BUG

其实早就注意到这个现象了,只不过最近才知道这是一个BUG。
上个月在闲逛日本的网站的时候发现有人提到了这个问题。
这个问题已经通过实验得到证实。
AU在做YUY2到AU内部的YUV444颜色空间的转换过程中会出现错误。具体的表现有两个,一个是左上角的部分像素颜色错误(在我这里的表现是呈现篇蓝色),另一个问题是颜色交界边缘出现颜色渗漏现象,尤其以红色为甚。估计是插值的时候参考像素选择错误造成的把。
这个问题只出现在YUY2到YUV444的转换,在其他的转换过程中似乎没有发现-0-

目前已知的有四个可以解决的插件:
1.yuy2_filter.auf
2.yuy2upsmp.auf
3.420444_filter.auf
4.ycexp.auf

实验环境:
用M2V解码,输出YUY2数据给AU,关闭所有插件,通过打开、关闭修正插件进行对比,图像放大到400%。

下面是贴图,修正前和修正后:
Image

声明:
这个问题是我发现之后跟○○氏(该人不愿意透露姓名)提出来的,主要实验都是○○氏完成的,我只是提出来问题、发表结果而已。
欢迎讨论。

图像压缩原理基础 连载3 时域模型与运动补偿

* 本文(包含其插图)严禁转载,并且不会同意您的转载请求。如有需要引用或介绍本文,您可以提供本文的连接。
时域模型的作用是消除连续帧之间的时域冗余。在时域模型中,当前帧减去参照帧得到残差图像,对残差图像进行编码,达到降低时域冗余的目的。参考帧选得越准确,所得到的残差图像能量越小,越容易压缩。
一个最简单的方法便是找过去的图像作为当前帧的参照帧。但这种方法有一个明显的不足,那就是残差图像的能量相对于我们的压缩需求来说依然过高,后续模型依然村在大量信息需要压缩。这个问题的主要原因是物体运动。因此要进一步降低数据量,必须对图像进行运动补偿。
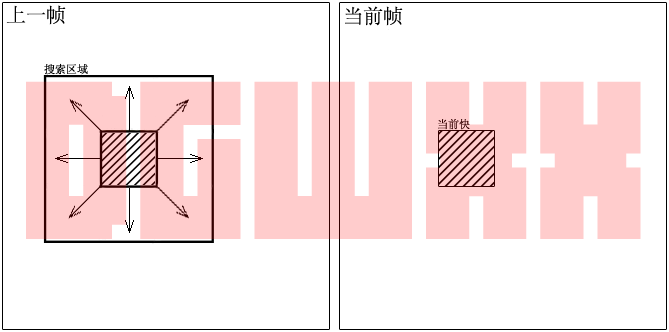
基于块的运动估计和补偿:现在普遍采用的运动补偿方法是基于块(Block)的运动估计和补偿。这种运动补偿方法首先将图像向划分成若干个块,分别对每个块进行运动补偿。下面简要说明其过程。
首先在参照帧中搜索当前块的匹配块。将当前块于参考帧特定搜索区域中(一般是以当前块的位置为中心的一片区域)所有块进行比较,找到相减后残差能量最小的块作为最佳匹配块。这个过程称为运动估计。之后,将最佳匹配块作为当前块的参照块,当前块减去参照块得到相应的残差块。此过程被称作运动补偿。对残差块进行编码和传输,同时运动向量(当前块和参照块之间的相对位置)也被编码和传输。
Image
基于块的运动补偿有多种优势,如计算复杂度低、适用于长方形视频图像、适合分块变换(DCT、DWT等等,下一节会说到)。单其同样也有缺点,如真实物体很少是长方形的、物体运动经常是非整数块、较复杂的运动和较复杂的形状不适合这种补偿方式等等。但抛开不足,基于分块的运动补偿算法仍旧是标准时域模型的基础。
运动补偿的块:在大多重要的视频编码标准中(如MPEG-1、MPEG-2、MPEG-4等等),宏块(16*16像素大小)是运动补偿的基本运算单位。在运动估计时,编码器在参考帧中寻找与当前宏块匹配的16*16像素区域,使匹配准则达到最小的16*16区域即为最佳匹配。当前宏块的位置与最佳匹配宏块的相对位置为运动矢量,当前宏块减去最佳匹配宏块所得到的残差宏块将于运动矢量一同被编码和传输。
块的大小:事实证明,运动补偿的块越小,得到的残差图像的能量越小。然而,分块越小,块越多,算法复杂度越高,矢量数目越多。传输矢量所需的数据量很可能大于图像残差能量减小所节省的数据量,这样一来就会造成得不偿失的情况。比较好的解决方法就是使用自适应的分块大小,对细节较少的部分采用大的分块,对细节较多的地方采用较小的分块。
像素插值:在很多情况下,利用插值后的像素位置进行预测将提高运动补偿的精度,原因在于,在插值后的像素位置上进行搜索时,有可能找到更好的匹配。下面简要说明1/4像素插值的运动补偿过程:
首先编码器在整数像素上找到一个最佳匹配,之后编码器对该位置附近进行半像素插值,之后在半像素的位置上继续搜索,寻找更好的匹配位置。如果找到了更好的匹配位置,则在该位置附近进行1/4像素插值,之后寻找更好的匹配。最后由当前块减去最佳匹配块得到残差块。
理论上说,插值越精细,运算复杂度越高,运动补偿效果越好,即得到的残差能量越小。但事实上,随着插值变得精细,其对于运动补偿的改善作用也在逐渐下降。打个比方,如果1/2像素插值能提高30%的性能,那么1/4插值很可能只能带来15%的提升,而1/8像素插值则可能仅有3%(不同的图像其提升作用不完全相同,以上数据仅为举例)。
运动补偿的精度:从运算复杂度上来说4*4分块加上1/4像素插值的运动补偿比起没有插值的16*16分块运动补偿复杂得多。从信息量上来说,由于每块的运动矢量同样需要参与编码并传输给解码器用于重建图像,因此随着分块尺寸变小,所需要编码和传输的运动矢量数目激增。同样,半像素、1/4像素插值搜索会造成运动矢量产生小数,运动矢量的小数部分必须和整数部分一起编码,所以会消耗更多的比特数。
因此,运动补偿精度越高,编码运动矢量消耗的比特数越多,编码残差图像消耗的比特数越少;反之,运动补偿精度越低,编码运动矢量消耗的比特数越少,编码残差图像消耗的比特数越多。
基于区域的运动补偿:除了基于宏块的运动补偿之外,还有基于区域的运动补偿等方法。但由于实现这种技术还存在诸多困难,所以现在应用较少。MPEG-4提供一些基于区域的运动补偿的工具,有兴趣学习的读者可以找来相关的资料学习。

参考资料:
《H.264和MPEG-4视频压缩——新一代多媒体的视频编码技术》 [英]Iain E.G.Richardson 著 欧阳合、韩军 译 国防科技大学出版社 2004年11月第一版

图像压缩原理基础 连载2 运动图像压缩基础(1)

* 本文(包含其插图)严禁转载,并且不会同意您的转载请求。如有需要引用或介绍本文,您可以提供本文的连接。

本节将抛开具体的编码器与运算原理,讲一讲一些运动图像压缩的基本思想与模型。
(1)运动图像压缩的可能性
信息(这里不仅仅指图像信息)可以被压缩,是因为其中包含着冗余。若将信息(数据)中的冗余去除,即可减少其数据量。
具体到运动图像信息的压缩,则是通过去除其中包含的统计冗余、空间冗余、时间冗余等来实现的压缩。我们经常提到的无损压缩,就是通过去除图像信息中的统计冗余来实现的。但是这样似乎并不够,因为目前对于视频的无损压缩算法只能获得很有限的压缩率。因此,现在多数使用的压缩技术是建立在有损压缩的基础之上的。有损压缩的代价是解压缩信号和原始信号不完全相同。因此,我们进行视频压缩的目的就是,在获得尽量高的压缩效率的同时使失真最小。

(2)视频编码器的模型
压缩是降低数据量的过程。而视频压缩,则是降低数字视频序列数据量的过程。视频压缩包括编码器(encoder)和解码器(decoder)两部分,合称为编解码器(CODEC)。
编码器需要通过某个模型来描述一段视频,这种模型既要兼顾压缩率,也要顾及压缩后的视频质量,使其尽可能地接近压缩前的图像。然而压缩率与质量通常是互相矛盾的:随着压缩率的提升,质量也随之下降。
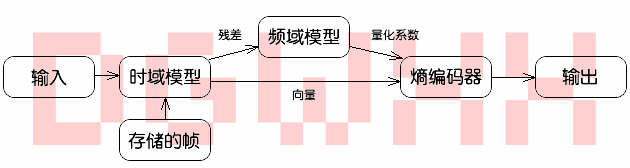
下面的图示展示了一个典型的视频其编码模型:
Image
典型的编码模型包括三个主要部分,时域模型、频域模型、熵编码器。相邻的帧之间具有较大的相似性,因此未压缩的视频流输入时域模型之后,时域模型通过建立预测帧来降低时域冗余。频域模型输入的是残差图像,利用同一幅图象中相邻像素点的相似性,消除残差图像的频域冗余。熵编码器对运动向量和变换系数进行压缩,消除存在的统计冗余,最后输出用于传输或存储的数据。

预告:简单分析过视频编码器的典型模型之后,我们将逐个讲解时域模型、频域模型、熵编码器的简单原理。
时域模型中具体是如何消除时域冗余的呢?运动估计、运动补偿、1/2插值又是什么呢?请期待下一节时域模型的讲解。

参考资料:
1.《多媒体技术基础》 雷运发主编 中国水利水电出版社 2005年4月出版
2.《H.264和MPEG-4视频压缩——新一代多媒体的视频编码技术》 [英]Iain E.G.Richardson 著 欧阳合、韩军 译 国防科技大学出版社 2004年11月第一版

图像压缩原理基础 连载1 JPEG静态图像压缩

从今天开始的《图像压缩原理基础》将会以大约每周一篇的速度,用浅显易懂的语言讲述静态图像以及动态图像压缩的原理。这个系列的文章既是我在向大家讲述视频压缩的基础知识,同时也是我在学习这些知识的“学习笔记”。
* 本文(包含其插图)严禁转载,并且不会同意您的转载请求。如有需要引用或介绍本文,您可以提供本文的连接。

本节以JPEG为例,讲解静态图像压缩的原理。JPEG图像压缩主要分为下面四个过程,离散余弦变换、量化、编码以及组成位数据流。下面通过一个简单的例子说明各步骤的原理。
1.离散余弦变换
(1)通过离散余弦变换(DCT变换,下略),可以将能量集中在矩阵左上角的少数几个系数上。简单地说,我们可以将DCT看作用一个8行8列的二维数组产生另一个8行8列的二维数组的函数。也就是说,把一个数组通过某种变换,变成另一个数组。
首先将一幅图像划分成一个个8*8像素的图像块。比如,原图的尺寸是640*480,那么将会被划分成80行60列的图像块。如果图像只包含灰度,那么每个象素都会用一个8bit的数字表示。因此可以将每个图像块表示成一个8行8列的二维数组,这个数组中每个元素都是0~255的8bit整数。DCT变换就是作用在这个数组上。再看一下彩色的情况。如果图像是彩色的,那么每个象素都可以用24bit、相当于3个8bit的组合来表示。因此可以用3个8行8列的数组来表示这个8*8的图像块。DCT变换作用于每一个数组。
(2)用f表示像素值的数组,f(i,j)表示第i行第j列的值,则DCT变换之后定义一个新的数组F(u,v)表示第u行v列的值。

DCT变换通过下面公式完成:
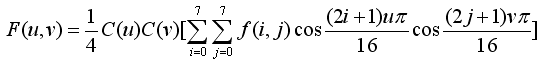
Image

逆DCT变换公式:
Image

在上面两公式中,当u,v=0时,Image,其他情况下,C(u),C(v)=1。
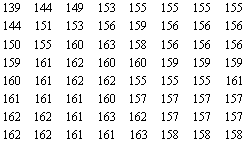
下面举例说明。下面矩阵表示一个8*8的图像样本的原始数组。
Image

为了便于计算,在进行变换之前先对原始图像中的每个样本数据减去128。然后再按照公式计算出数组中每个元素的值。举F(0,0)的值的计算过程如下:
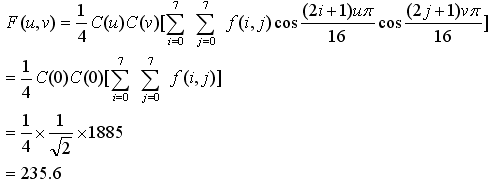
Image

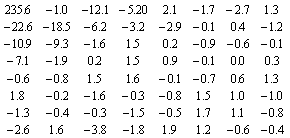
按照这样,继续计算其他值:
Image

f(i,j)经过DCT变换之后得到了F(i,j),其中F(0,0)是直流系数,称为DC系数,其他的为交流系数,称为AC系数。

2.量化
为了达到压缩的目的,我们需要对经过DCT变换的DCT系数进行量化,目的是减小非0系数的幅度以增加0值系数的数目。在一定的主观保真的前提下,丢掉那些对视觉效果影响不大的数据。量化是压缩过程中造成质量下降的最主要原因。
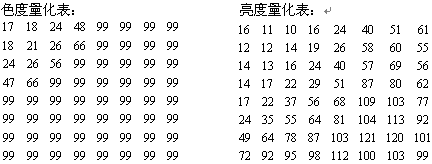
因为人眼对于亮度的感知能力高于色度,JPEG压缩时使用了两个量化表——色度量化表和亮度量化表。
Image

对于上面的例子,我们使用亮度量化表对其进行量化,得到数组Q(i,j)。量化的公式是:
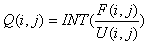
Image

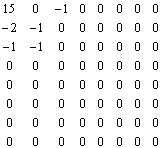
其中U(i,j)为量化表中第i行j列的值。也就是说,要用数组F中的每一个元素除以量化表中起对应位置的值。按照这个公式,我们对上面例子中的数组F进行量化后得到如下结果Q:
Image

我们很高兴地看到,呃……基本上都变成了0。

3.编码
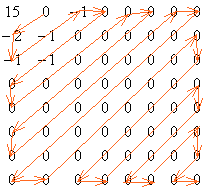
z形排列:对图像块进行DCT变换后,能量集中在矩阵左上角的少数几个系数上。所以一般左上角的数值比较大,而0则主要集中在矩阵右下角。为了增加连续的0的个数,我们采用z形排列(zigzag),以便更好地压缩数据。这样,我们就能把一个8*8的矩阵转换成一个1*64的矢量。我们将上面经过量化的结果Q进行z形排列,如下所示:
Image

经过z形排列之后,结果变成了:15 0 -2 -1 -1 -1 0 0 -1 0 0 ……后面全部是连续的0,这样一来,连续0的个数变多了。
DC系数编码:8*8图块经过DCT变换后得到的DC系数有两个特点,一个是数值很大,另一个是相邻两个图块之间的DC系数很相近。因此,JPEG采用取DPCM编码对DC系数差进行编码。公式如下:
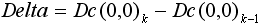
Image

其中Delta为差值,即差值为当前图块DC系数减去上一个图块的DC系数。
AC系数的编码:经过量化的AC系数的特点是有很多连续的0。所以可以使用非常简单和直观的RLE编码对其进行编码。
霍夫曼编码([size=-1]*注1 注2):在JPEG有损压缩中,使用霍夫曼编码来减少熵(读Shang,1声)。压缩数据符号的时候,霍夫曼编码器对出现频率较高的符号使用较短的代码,对于出现频率较低的符号使用较长的代码,最终使得编码的平均码字最短。

4.组成数据位流
JPEG编码的最后一步为把各种标记代码和编码后的图像组成数据,这样做的目的是为了便于传输、存储和译码器进行译码。

注1:JPEG标准也允许(但是并不要求)使用在数学上优于霍夫曼编码的算术编码。然而,这个特色几乎很少被使用,因为它被专利所涵盖,且它相较于霍夫曼编码在编码和解码上会更慢。使用算术编码一般会让档案更小约 5%。
注2:Huffman编码,除“霍夫曼编码”外,还有“哈夫曼编码”等其他译法存在。

本文参考资料:
《多媒体技术基础》 雷运发主编 中国水利水电出版社 2005年4月出版
中文Wikipedia中关于JPEG的条目:http://zh.wikipedia.org/wiki/JPEG